中间这五步都是自动的。想插手的话,可以在翻译完先停下来校对,再接着配音。
听出原片里每一句话和它的时间。已有字幕就直接用,跳过这一步。
中文 SenseVoice · 英日 系统语音识别按整句翻译,配音才有语气。可以用免费的系统翻译,也可以填自己的 Key。
Apple · Google · DeepSeek · 智谱从原片里截一段约 10 秒的人声当参考,逐句用这个音色念出译文。
Qwen3-TTS,本机运行配音保持正常语速,说话那段画面跟着拉长或缩短,句子之间的停顿保持原样。
最多加速到 1.5 倍烧上字幕导出成片,另外附一份无字幕版和对齐好的字幕文件。
系统自带 AVFoundation,不用装 ffmpeg结果都保存在源文件旁边。可以一次拖进多个文件,排成队列按顺序做。
用原声的音色把译文念出来,画面跟着配音调速,得到一条新语言的视频。默认烧双语字幕。
名字_en.mp4名字_en_无字幕.mp4名字_en.srt原声原画面不动,把上下两行的双语字幕烧进视频。适合采访、课程、口播。
名字_双语.mp4只出字幕:原文、译文、双语各一份,一行放得下、断句干净,拿去自己的剪辑软件里用。
名字.zh.srt名字.en.srt名字.zh+en.srt你已经有译好的字幕,直接用原声音色按它配音。纯音频也行,输出 wav。
名字_zh.mp4名字.wav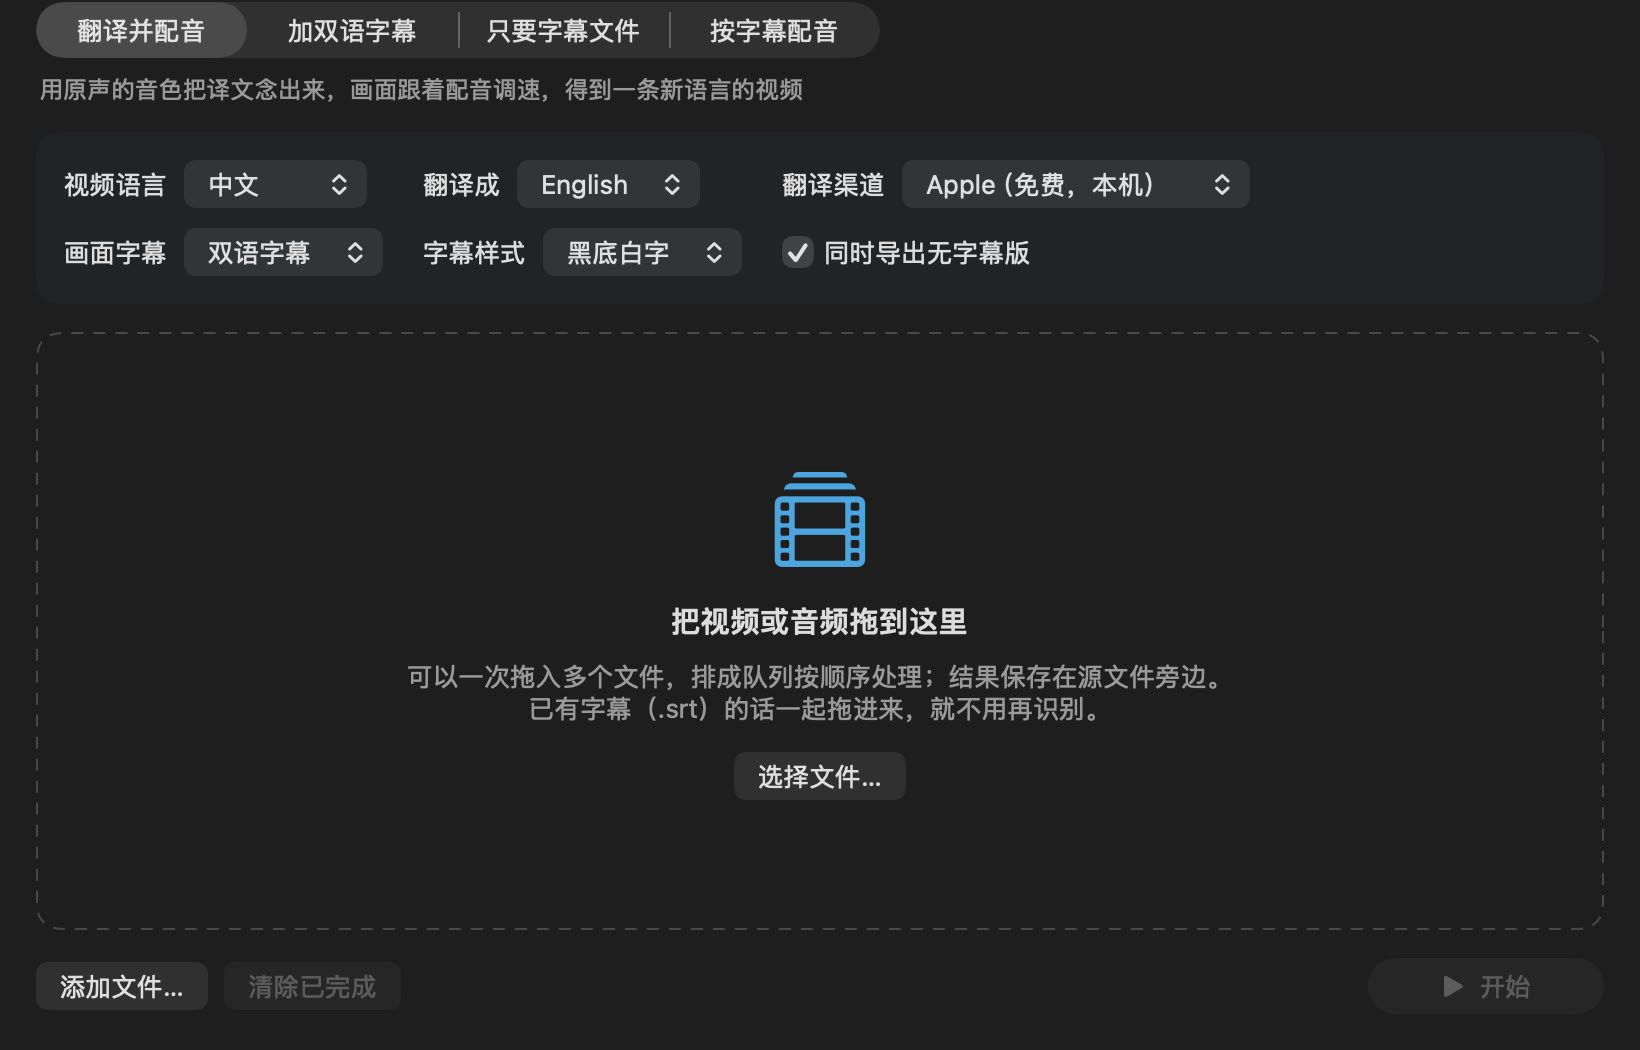
打开校对窗口,左边是视频,右边一句一句列出原文和译文。点哪句画面就停在哪句。
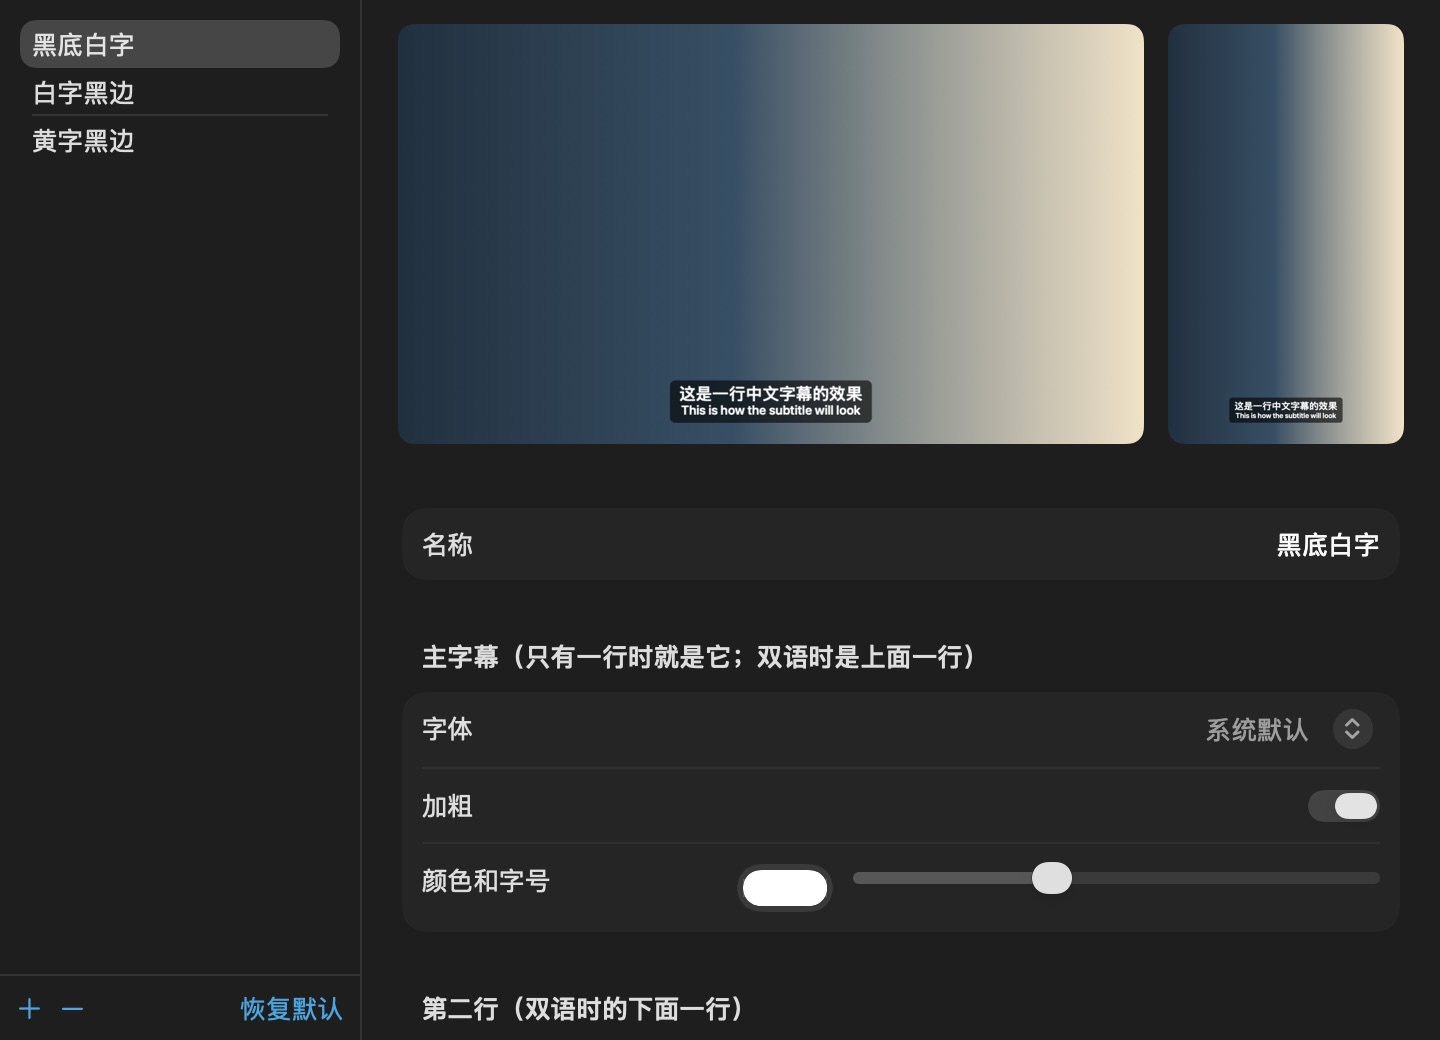
字体、字号、颜色、描边、底框、位置都能调,双语的第二行可以单独换字体。改的时候横屏、竖屏两张预览一起变,调好存成一套样式,下次直接选。
识别和配音的模型都跑在 Mac 上,第一次用的时候下载。翻译默认也用系统自带的,要接大模型才需要联网。
识别、系统翻译、配音都在本机跑,没有按时长计费的云端接口。用大模型翻译时,填的是你自己的 Key。
音色直接取自原片:自动挑一段约 10 秒的清晰人声做参考,不用另外录音、不用训练。
填进来的 API Key 存在 macOS 钥匙串里,用到的时候才读,不写进普通设置文件。
| 系统 | macOS 26 或更高版本,Apple 芯片(M 系列) |
|---|---|
| 内存 | 只做字幕 8 GB 就够;配音推荐 16 GB 及以上;「本机 · 高质量」配音推荐 32 GB |
| 首次下载 | 中文识别模型约 230 MB;配音模型标准版约 1.9 GB、高质量版约 2.9 GB。断了能接着下,连不上会自动换下载源 |
| 语言 | 中文、英文、日文互译和配音 |
| 格式 | mp4、mov、m4a、mp3、wav 等系统能解码的格式(暂不支持 mkv) |
| 速度 | 在 M2 Max 上实测:一条 38 秒的样片,模型下载好之后,翻译并配音整个流程约 31 秒 |
译哥(谐音八哥)、Poly(Polly + polyglot)。正在内测,正式版上架后会在这里更新。